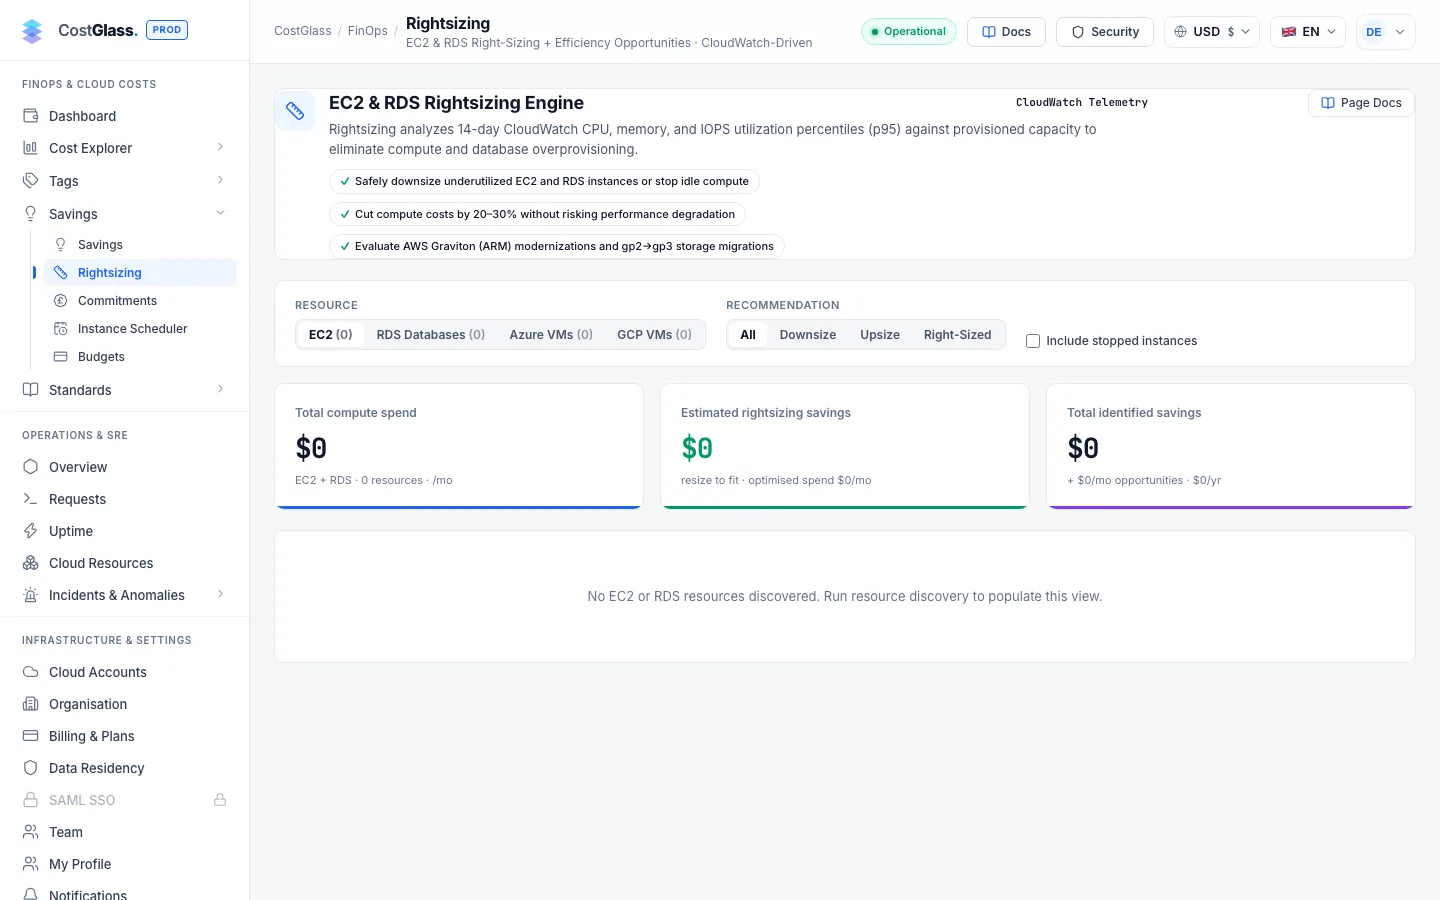
Rightsizing (Ressourcenanpassung)
Find servers and databases that are too big, or too small, using real CPU and memory measurements.
Rightsizing (Ressourcenanpassung)
Rightsizing vergleicht die Größe jedes Servers oder jeder Datenbank mit der Menge davon, die Sie tatsächlich nutzen, und empfiehlt basierend auf realen Messungen eine kleinere (oder eine größere) Größe.
- Empfehlungen kommen von gemessen Nur CPU und Speicher. Keine Kennzahlen bedeuten keine Empfehlung, und auf der Seite wird erklärt, warum.
- Für AWS benötigen Sie Rightsizing (Ressourcenanpassung) Funktion in Ihrem CostGlass-Stack aktiviert und über 7 Tage von Metriken (12,5 Tage für Leerlaufprüfungen).
- CPU ist immer verfügbar. Der Speicher wird nur gemessen, wenn Sie den CloudWatch-Agenten; Ohne sie ist das Vertrauen geringer.
- Bei den Preisen handelt es sich um On-Demand-Listenpreise aus den ungefähren Tabellen von CostGlass. Betrachten Sie die Einsparungen also als Richtschnur.
- CostGlass ändert nie die Größe von irgendetwas. Die Änderung nehmen Sie selbst vor, idealerweise zunächst in einer Testumgebung.
Was Rightsizing bedeutet
Wenn jemand einen Server erstellt, wählt er „aus Sicherheitsgründen“ oft eine großzügige Größe und wird nie wieder darauf zurückgegriffen. Sie zahlen jede Stunde für die gesamte Größe, auch wenn nur ein Bruchteil davon verbraucht wird. Rightsizing findet diese Server und schlägt die nächstkleinere Größe derselben Familie vor, wodurch der Preis dieses Servers sinkt. Außerdem werden Server angezeigt, die zu heiß laufen und bei denen eine größere Größe Ihre Kunden schützen würde.
- CPU p95
- Das 95. Perzentil der CPU-Nutzung: der Wert, der nur in 5 % der Fälle überschritten wurde. Es beschreibt die geschäftigen Zeiten und ignoriert die allerseltensten Spitzen. It is a better guide to "how big does this need to be" than the average.
- Speicher p95
- Das gleiche Maß für das Gedächtnis.
- Familie und Größe
- Ein Servertyp wie m6i.large hat eine Familie (m6i) und eine Größe (groß). CostGlass empfiehlt die benachbarte Größe in der Schritt für Schritt in die gleiche Familie zu gehen, denn das ist die sicherste Veränderung.
- Konfidenz
- Wie viele Belege hinter einer Empfehlung stehen: Hoch, Mittel oder Niedrig (unten erklärt).
Woher die Messungen stammen
| Wolke | Quelle | Was Sie tun müssen |
|---|---|---|
| AWS EC2 und RDS | Amazon CloudWatch (GetMetricData, last 14 days, hourly). Memory comes from the CloudWatch agent (CWAgent) if it is installed. AWS Compute Optimizer wird ebenfalls gelesen, da in jeder Zeile eine Zweitmeinung angezeigt wird. | Aktivieren Sie „Rightsizing“ in Ihrem Stapel. Installieren Sie den CloudWatch-Agenten für den Speicher. Optional können Sie sich für Compute Optimizer anmelden. |
| Virtuelle Azure-Maschinen | Azure Monitor (CPU plus verfügbarer Speicher dort, wo die VM dies meldet). | Nichts Besonderes. Der Lesezugriff reicht aus. |
| Google Cloud | Cloud Monitoring wird heute nicht gelesen, daher wird für VMs Metrikzugriff erforderlich angezeigt. | Noch nichts verfügbar. |
| Kubernetes | OpenCost: Effizienz der Containeranforderungen jeder Workload. | Verbinden Sie OpenCost. Siehe Kubernetes-Kosten. |
| KI-Modelle | Ihre tatsächlichen OpenAI- oder Anthropic-Ausgaben nach Modell. | Verbinden Sie die KI-Plattform. |
Einrichten (AWS)
- Ein AWS-Konto, das mit Live-Zugriff verbunden ist (nicht nur ein Abrechnungsexport).
- Jemand, der einen CloudFormation-Stack in diesem Konto bereitstellen oder aktualisieren kann.
- Server, die seit mindestens einer Woche laufen.
mem_used_percent. Ohne sie werden immer noch nur CPU-Empfehlungen gegeben, allerdings mit geringerer Zuverlässigkeit und mit einer Erinnerung, zuerst den Speicher zu überprüfen.Es gelten die Regeln von CostGlass
Die Schwellenwerte sind festgelegt und gelten für jeden Kunden.
| Empfehlung | Wenn es gemacht ist | Beweise erforderlich |
|---|---|---|
| Verkleinern | CPU p95 unter 40 % und Speicher p95 unter 40 %, wenn der Speicher gemessen wird, und der eine Nummer kleinere Server würde nach der Änderung immer noch bei oder unter 80 % p95 bleiben. Die Ersparnis muss außerdem mehr als 5 % des aktuellen Preises betragen. | 7 Tage |
| Vergrößern | CPU p95 bei oder über 85 % oder Speicher p95 bei oder über 90 %. Wird als Zusatzkosten angezeigt (negative Ersparnis) und ist nicht in den Ersparnissummen enthalten. | 7 Tage |
| Leerlauf | EC2: durchschnittliche CPU unter 3 %, p95 unter 10 % und Netzwerk unter 100 MB pro Tag. RDS: überhaupt keine Datenbankverbindungen. | 12,5 Tage |
| Richtige Größe | Nichts oben Genanntes trifft zu. Lass es in Ruhe. | 7 Tage |
| Keine Nutzungsdaten | Nicht genügend Verlauf, wird nicht ausgeführt, keine Region aufgezeichnet oder CloudWatch hat nichts zurückgegeben. In der Zeile wird der Grund angegeben. | - |
| Benötigt Zugriff auf Metriken | CostGlass kann keine Metriken für diese Cloud lesen (derzeit Google Cloud VMs). | - |
Konfidenz
| Ebene | Wann |
|---|---|
| Hoch | Es wurden Daten und Speicher von mindestens 12,5 Tagen gemessen. |
| Mittel | Mindestens 12,5 Tage Daten, aber der Speicher wurde nicht gemessen. Oder die hohe Konfidenz wird verringert, weil kurze Bursts die Grenze der aktuellen Größe erreichen. |
| Niedrig | Zwischen 7 und 12,5 Tage an Daten oder aufgrund von Ausbrüchen mittelmäßig verringert. |
Wenn Bursts (die Spitze, nicht p95) die Kapazität des kleineren Servers überschreiten würden, heißt es in der Erklärung: „Kurze Bursts erreichen die Grenze der aktuellen Größe. Überprüfen Sie daher die Spitzenlast, bevor Sie die Größe ändern.“
So lesen Sie die Seite
Kopfkarten
- Gesamtausgaben für Flotte und KI
- Geschätzte monatliche Kosten der analysierten Ressourcen zum Listenpreis.
- Größeneinsparungen (gemessen)
- Die Summe der Einsparungen durch Empfehlungen basierend auf der gemessenen Nutzung. Schätzungen für Ressourcen ohne Metriken sind nicht enthalten. Before data exists this card reads "No utilisation data yet".
- Gesamte identifizierte Einsparungen
- Einsparungen bei der Größenanpassung sowie die weiter unten auf der Seite aufgeführten zusätzlichen Effizienzmöglichkeiten.
Plattform-Registerkarten und Filter
Choose a platform with All Platforms, Kubernetes, AWS, Azure, Google Cloud or AI Models (the number in brackets is how many items it holds). Wählen Sie unter „Empfehlung“ „Alle“, „Verkleinern“, „Inaktiv“, „Vergrößern“, „Rechte Größe“ oder „Keine Daten“ aus. Aktivieren Sie „Einschließen gestoppt“, um Server einzubeziehen, die nicht ausgeführt werden.
| Kontrolle | Optionen |
|---|---|
| Suchen Sie nach Name, ID, Anbieter oder Größe ... | Freitext. |
| Alle Regionen/Cluster | Beschränken Sie sich auf eine Region oder einen Kubernetes-Cluster. |
| Irgendein Vertrauen | Hoch, Mittel oder Niedrig. |
| Sortieren | Biggest saving first (default), Highest cost first, Name A–Z. |
Die Tabelle
| Spalte | Was es Ihnen sagt |
|---|---|
| Ressource / Arbeitsbelastung | Name, Cloud-Abzeichen, Region und Bundesland. |
| Aktuelle Spezifikation | Instanztyp mit vCPU und Arbeitsspeicher. |
| Aktuelle £/Monat | Geschätzter monatlicher Listenpreis jetzt (angezeigt in der von Ihnen gewählten Währung). |
| CPU p95 | Leiste zeigt die ausgelastete CPU an. Ein Bindestrich bedeutet nicht gemessen. |
| Mem p95 | Das Gleiche gilt für das Gedächtnis. Ein Bindestrich bedeutet, dass der Speicher nicht gemessen wird (siehe CloudWatch-Agent). |
| Empfohlene Größe/Stufe | Die Urteilspille und, für Downsize oder Upsize, der Zieltyp. |
| Neu £/Monat | Listenpreis der empfohlenen Größe. |
| Sparen Sie £/Monat | Der Unterschied. Ein negativer Betrag (gelb) bedeutet eine Erhöhung der Kosten. |
Klicken Sie auf eine Zeile, um sie zu erweitern: CPU-Durchschnitt und p95, Speicher p95, Spitzennetzwerk oder Verbindungen, die Datenquelle, das Ergebnis von AWS Compute Optimizer (sofern Sie sich dafür entschieden haben), Vertrauen, neue Kapazität und eine verständliche Begründung.
Zusätzliche Möglichkeiten
Unterhalb der Tabelle listet „Cross-Platform Optimization Opportunities“ Effizienzgewinne auf, die Sie in Ihrem Inventar gefunden haben: nicht angeschlossene Festplatten, Instanztypen der vorherigen Generation, Graviton- oder ARM-Verschiebungen, Prompt-Caching und Batch-APIs für KI. Dabei handelt es sich nicht um eine gemessene Auslastung, sondern sie werden getrennt von der gemessenen Einsparsumme geführt.
So führen Sie eine Empfehlung sicher durch
Ehrliche Grenzen
- Keine Kennzahlen, keine Empfehlung. CostGlass modelliert oder schätzt die Nutzung nicht. Ein Server, der nicht gemessen werden kann, wird mit dem Grund angezeigt.
- Die Preise sind ungefähre Angaben. Es handelt sich um On-Demand-Listenpreise aus den integrierten Tabellen von CostGlass. Preise, Gutschriften und Rabatte für reservierte oder Sparpläne werden nicht angewendet, daher können die tatsächlichen Einsparungen abweichen. Azure-Speicher und Preise sind ebenfalls Näherungswerte.
- Nur die Nachbargröße im gleiche Familie wird empfohlen. Der Wechsel zu einer anderen Familie (zum Beispiel zu Graviton) erscheint als zusätzliche Chance und nicht als maßvolle Empfehlung.
- Die Metriken decken die letzten 14 Tage ab. Ein geschäftiges Monatsende kann hinter ruhigen zwei Wochen verborgen bleiben.
- Google Cloud VMs show Needs metrics access: CostGlass does not yet read Cloud Monitoring.
- Die Vorschläge für KI-Modelle auf dieser Seite basieren auf festen Annahmen über die Modellebenen und sind nicht Teil der gemessenen Gesamtsumme.
- Die Ergebnisse der Dimensionierung hängen von der Ressourcenerkennung ab. Ein Server, der nicht erkannt wurde, wird nicht angezeigt.