Verfügbarkeit, Vorfälle & Support
Monitor public endpoints, route alerts, see incidents and raise requests to CostGlass engineers.
Verfügbarkeit, Vorfälle & Support
Beobachten Sie Ihre öffentlichen Endpunkte, lassen Sie sich benachrichtigen, wenn sie ausfallen, sehen Sie sich aufgezeichnete Vorfälle an und bitten Sie die CostGlass-Ingenieure um Hilfe.
- Uptime sendet eine HTTP-Anfrage an jede öffentliche URL, die Sie registrieren, und zeichnet Status, Antwortzeit und Zertifikatsablauf auf. In der Produktion läuft die Prüfung etwa alle fünf Minuten.
- Eine Prüfung besteht nur bei einer 2xx-Antwort innerhalb von 5 Sekunden. Alles andere markiert den Dienst als beeinträchtigt und löst eine Warnung aus.
- Benachrichtigungen werden je nach Umgebungskategorie oder Dienst an Slack, PagerDuty, Microsoft Teams oder per E-Mail gesendet.
- Auf der Seite „Vorfälle“ werden offene Vorfälle aufgeführt, die für Ihre Organisation erfasst wurden. CostGlass löst sie bei fehlgeschlagenen Prüfungen nicht automatisch aus und die Seite verfügt über keine Schaltfläche zum Erstellen.
- Support & Requests ist Ihr Ansprechpartner für die CostGlass-Ingenieure: Stellen Sie eine Aufgabe, einen Fehler, eine Funktionsanfrage oder eine Frage und verfolgen Sie diese.
- Ein Wachstums-, Skalierungs- oder Unternehmensplan. Der Menüpunkt „Verfügbarkeit“ ist unter „Wachstum“ ausgegraut.
- Besitzer- oder Administratorrolle zum Registrieren von Diensten, Ändern von Kategorien oder Kanälen.
- Eine öffentliche HTTP- oder HTTPS-URL, die im fehlerfreien Zustand einen 2xx-Status zurückgibt, z. B. /health, /healthz oder /status. Es sollte sicher sein, wiederholt anzurufen.
- Für Benachrichtigungen: ein eingehender Slack-Webhook, ein Teams-Webhook, ein PagerDuty-Integrationsschlüssel oder eine E-Mail-Adresse.
Was die Verfügbarkeitsüberwachung leisten kann
Die Betriebszeit ist eine synthetische Prüfung: CostGlass führt einen HTTP-GET zu der von Ihnen angegebenen URL durch und beurteilt die Antwort. Es kann nur überwachen öffentliche HTTP/HTTPS-Endpunkte. Eine Lambda-Funktion, eine RDS-Datenbank oder ein Kubernetes-Workload ohne URL können auf diese Weise nicht überwacht werden; Für den Zustand dieser verwenden Sie Cloud-Ressourcen. Eine Seitenkarte auf Uptime sagt dasselbe und enthält Links zu den Discovery-Vorlagen.
Betriebszeit: Benachrichtigungsregeln für Kategorien oben, überwachte Dienste unten.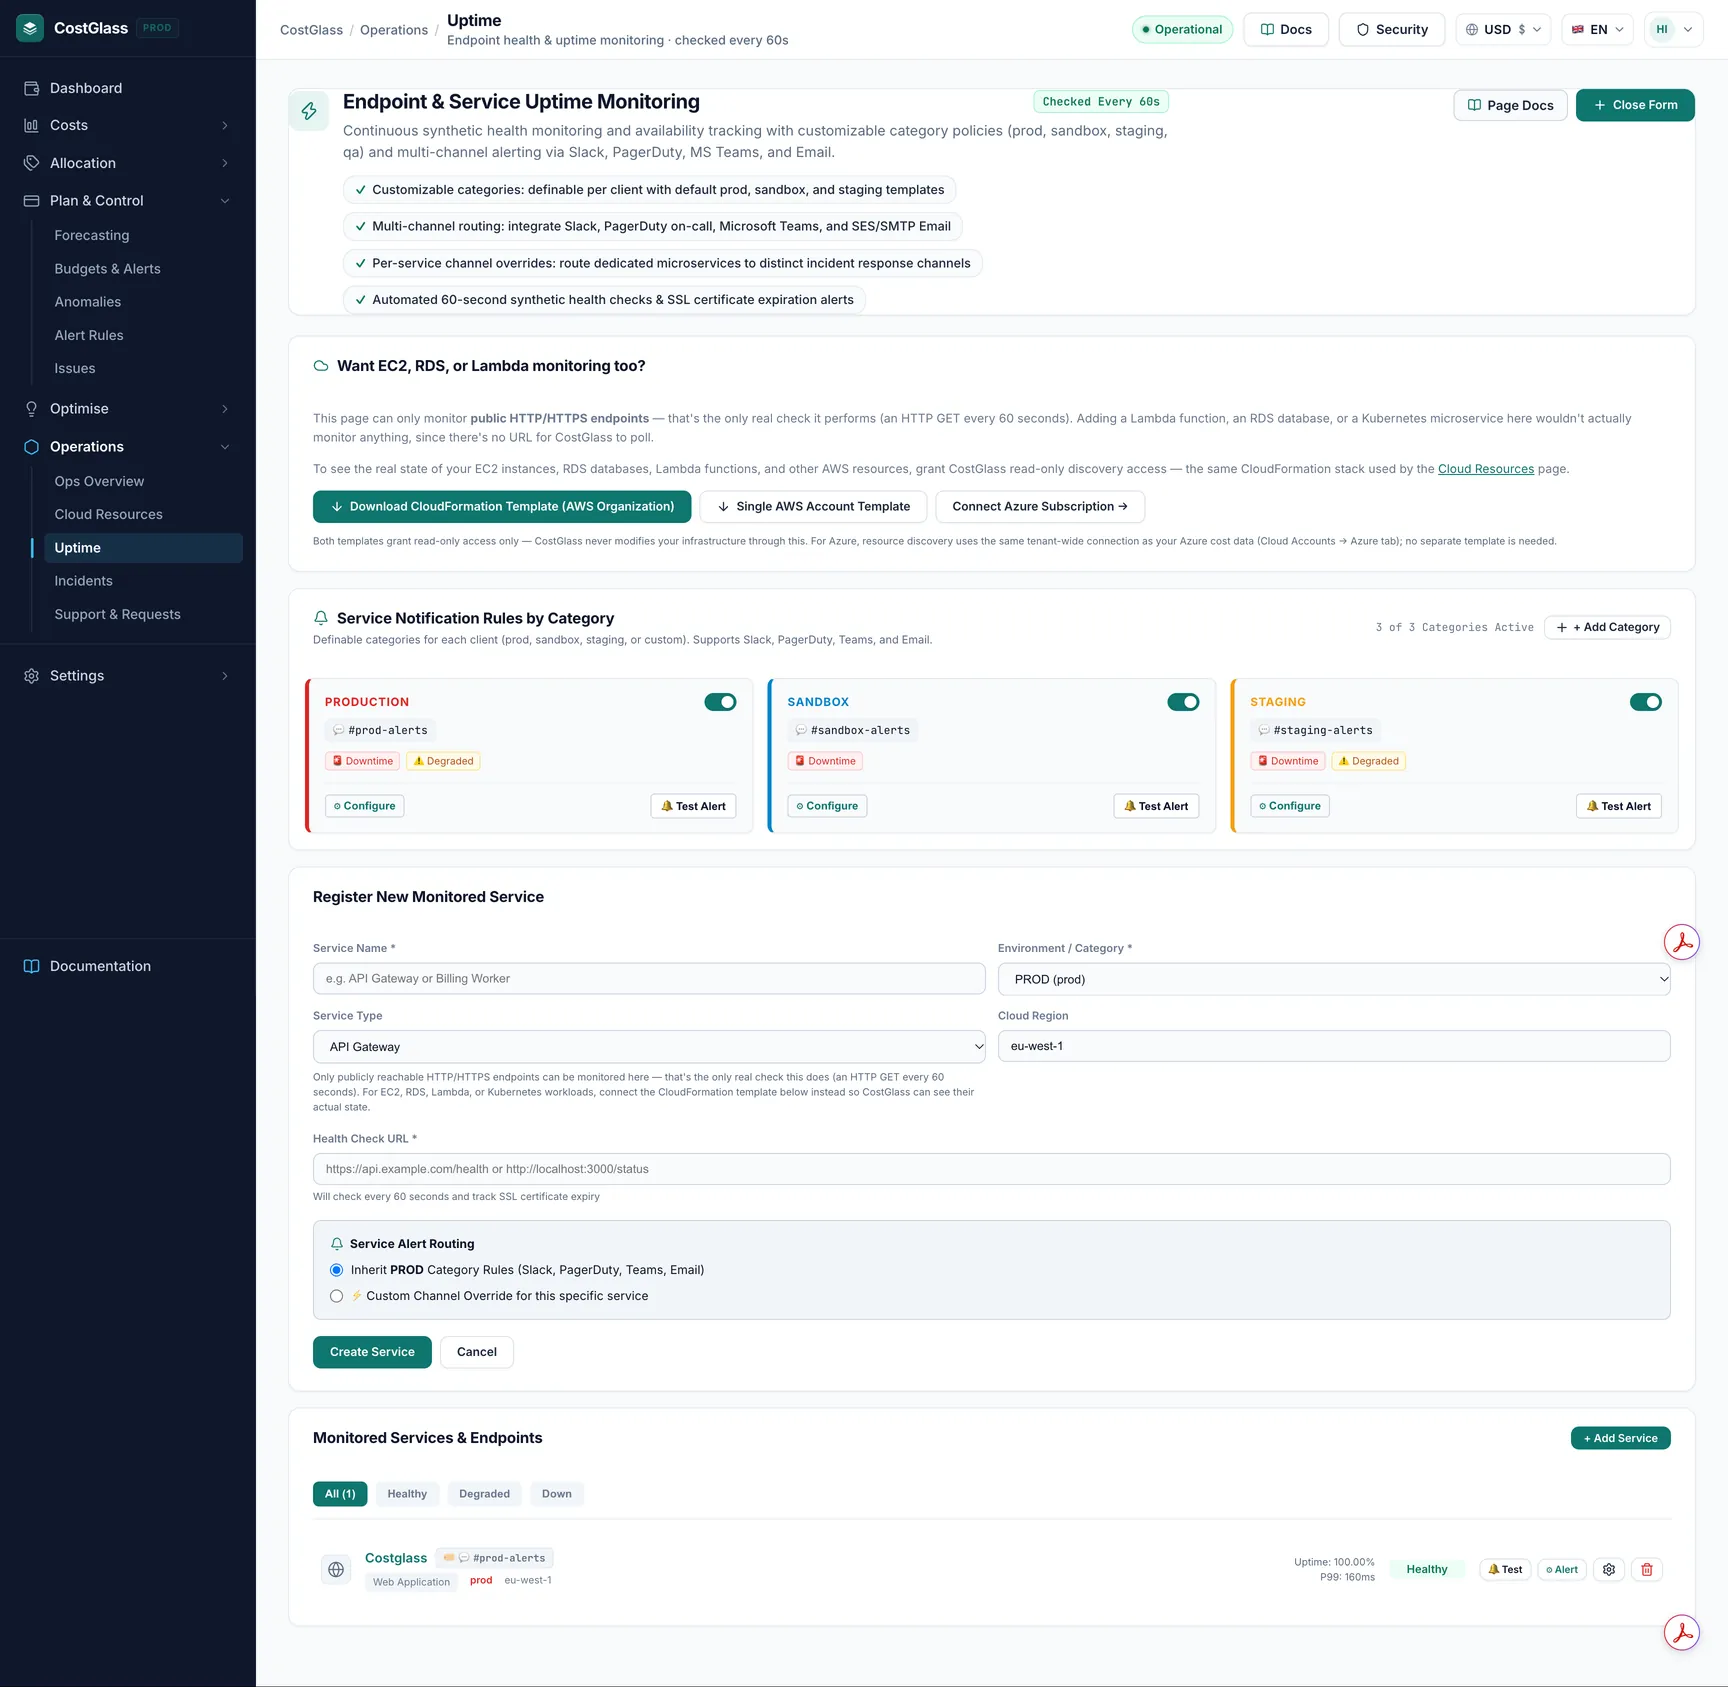
| Was wird aufgezeichnet | Detail |
|---|---|
| Status | Gesund wenn die Antwort 2xx ist; Degradiert andernfalls (einschließlich Zeitüberschreitungen und Verbindungsfehlern). Weiterleitungen werden befolgt. |
| Latenz | Antwortzeit der letzten Prüfung. Wird in der Servicezeile als P99 angezeigt. |
| SSL | Tage bis zum Ablauf des HTTPS-Zertifikats. Die Reihe wird erst bernsteinfarben und dann rot, wenn sie sich nähert. |
| Betriebszeit % | Eine laufende Zahl, die bei jeder erfolgreichen Prüfung um 0,01 steigt und bei jedem Fehler um 0,05 sinkt, zwischen 0 und 100. Es handelt sich um einen Trendindikator und nicht um eine echte 30-Tage-Verfügbarkeitsberechnung. |
Dienst hinzufügen
https://api.example.com/health. Ohne URL lässt sich das Formular nicht speichern.The service list has filter buttons for all, healthy, degraded and down, and per row: 🔔 Test, ⚙ Alert, edit and delete (with confirmation). Click a service for its detail page: Current Status, SSL Expires In, Response Latency and Service Status charts. Neue Dienste müssen ein paar Mal überprüft werden, bevor die Diagramme ausgefüllt werden.
Benachrichtigungskanäle
Kategorieregeln
Service Notification Rules by Category defines default channels per environment (prod, sandbox, staging, or categories you add with + Add Category). Jede Kategorie kann aktiviert oder deaktiviert werden, zeigt „Keine Kanäle konfiguriert“ oder „Stumm“ an, wenn nichts eingestellt ist, und kann über herabgesetzte und heruntergefahrene Zustände benachrichtigen. Benutzerdefinierte Kategorien können gelöscht werden.
Überschreibung pro Dienst
Click ⚙ Alert on a service and choose Select Alert Routing Behavior: inherit the category's channels, or Custom Alert Channels Override for this specific service. Fügen Sie Ziele mit den Schaltflächen Slack, PagerDuty, Teams und E-Mail hinzu und senden Sie jeweils einen Test.
| Kanal | Sie sorgen dafür |
|---|---|
| Locker | Ein Kanalname und/oder eine eingehende Webhook-URL (https://hooks.slack.com/…). |
| PagerDuty | Ein 32-stelliger Integrationsschlüssel. |
| Microsoft-Teams | Eine Teams- oder Workflows-Webhook-URL. |
| Eine oder mehrere Adressen. |
- Webhook-URLs und -Schlüssel sind schreibgeschützt: Nach dem Speichern sehen Sie nur die letzten paar Zeichen, und wenn Sie das Feld leer lassen, bleibt der gespeicherte Wert erhalten.
- Webhook-Hosts werden anhand einer Zulassungsliste der echten Slack- und Teams-Hosts überprüft. alles andere wird abgelehnt.
- Test-E-Mails gehen immer nur an Ihre eigene Adresse, welche Empfänger auch immer konfiguriert sind. Echte Benachrichtigungen gehen an die gespeicherten Empfänger.
- Ein PagerDuty-Test erzeugt einen echten Vorfall in PagerDuty.
- Nur Eigentümer und Administratoren können Kategorien und Kanäle ändern, und ein Dienst, für den nichts konfiguriert ist, kann nicht getestet werden.
Grenzen von Alarmierungen
- Der Prüfer markiert Fehler als „Herabgestuft“. Der Down-Filter ist vorhanden, aber eine fehlgeschlagene Prüfung führt derzeit nicht zu einem separaten Down-Status.
- Es werden nur HTTP-Prüfungen (und Kubernetes-Bereitstellungsprüfungen für mit einem Cluster verknüpfte Dienste) durchgeführt.
- Gespeicherte Kanalgeheimnisse für einzelne Dienste werden in der Datenbank gespeichert; Anomalieregelgeheimnisse werden in einem Geheimspeicher aufbewahrt.
Vorfälle
Incidents (titled Production Incident Management) shows open incidents as cards with title, description, severity P1 to P4, status and start time, or No open incidents with an All Clear badge.
| Schwere | Farbe | eingereicht haben? Bedeutung |
|---|---|---|
| P1 | Rot | Am schwersten. |
| P2 | Bernstein | Ernst. |
| P3 | Blau | an Mäßig. |
| P4 | Grün | Unerheblich. |
Das Ops-Übersichts-Cockpit fasst Online-Services, entdeckte Assets, offene Vorfälle und Ihre aktiven Anfragen zusammen.
Support & Anfragen
Stellen Sie bei CostGlass alles, was Sie brauchen: DevOps/SRE-Arbeit, eine Funktionsanfrage, einen Fehlerbericht oder eine Frage. Open Support & Requests and click + New Request.
Was passiert, nachdem Sie
- Die E-Mail wird an die Ihrer Organisation zugewiesenen Ingenieure und die Betreiber der CostGlass-Plattform gesendet und mit der Anfrage im Backoffice für Ihre Region verknüpft.
- Sie erhalten eine Bestätigungs-E-Mail. Wenn in Ihrem Konto keine E-Mail-Adresse gespeichert ist, können Sie nichts senden.
- Wenn ein Techniker zugewiesen wird, wird er per E-Mail benachrichtigt. Wenn sich der Status ändert, werden Sie per E-Mail benachrichtigt.
- E-Mail-Probleme führen nie dazu, dass die Anfrage gespeichert wird.
Seite lesen
The KPI strip shows Active Requests, SLA & Resolution, Assigned SRE Bench and Completed Tasks. Tabs filtern nach „Alle“, „In Bearbeitung“, „Offen“ und „Abgeschlossen“; Ein Prioritäts-Dropdown und eine Suche schränken die Liste ein. Die Status sind „Offen“, „In Bearbeitung“, „Warten auf Überprüfung“ und „Abgeschlossen“.