Rightsizing (ajustement de taille)
Find servers and databases that are too big, or too small, using real CPU and memory measurements.
Rightsizing (ajustement de taille)
Le dimensionnement compare la taille de chaque serveur ou base de données avec la quantité que vous utilisez réellement et recommande une taille plus petite (ou plus grande) en fonction de mesures réelles.
- Les recommandations viennent de mesuré CPU et mémoire uniquement. Aucune mesure ne signifie aucune recommandation, et la page explique pourquoi.
- Pour AWS, vous avez besoin du Rightsizing (ajustement de taille) fonctionnalité activée dans votre pile CostGlass, et à propos de 7 jours de métriques (12,5 jours pour les contrôles inactifs).
- Le processeur est toujours disponible. La mémoire n'est mesurée que si vous installez l'agent CloudWatch; sans cela, la confiance est moindre.
- Les prix sont des prix catalogue à la demande issus des propres tableaux approximatifs de CostGlass, alors considérez les économies comme un guide.
- CostGlass ne redimensionne jamais rien. Vous effectuez le changement vous-même, idéalement dans un premier temps dans un environnement de test.
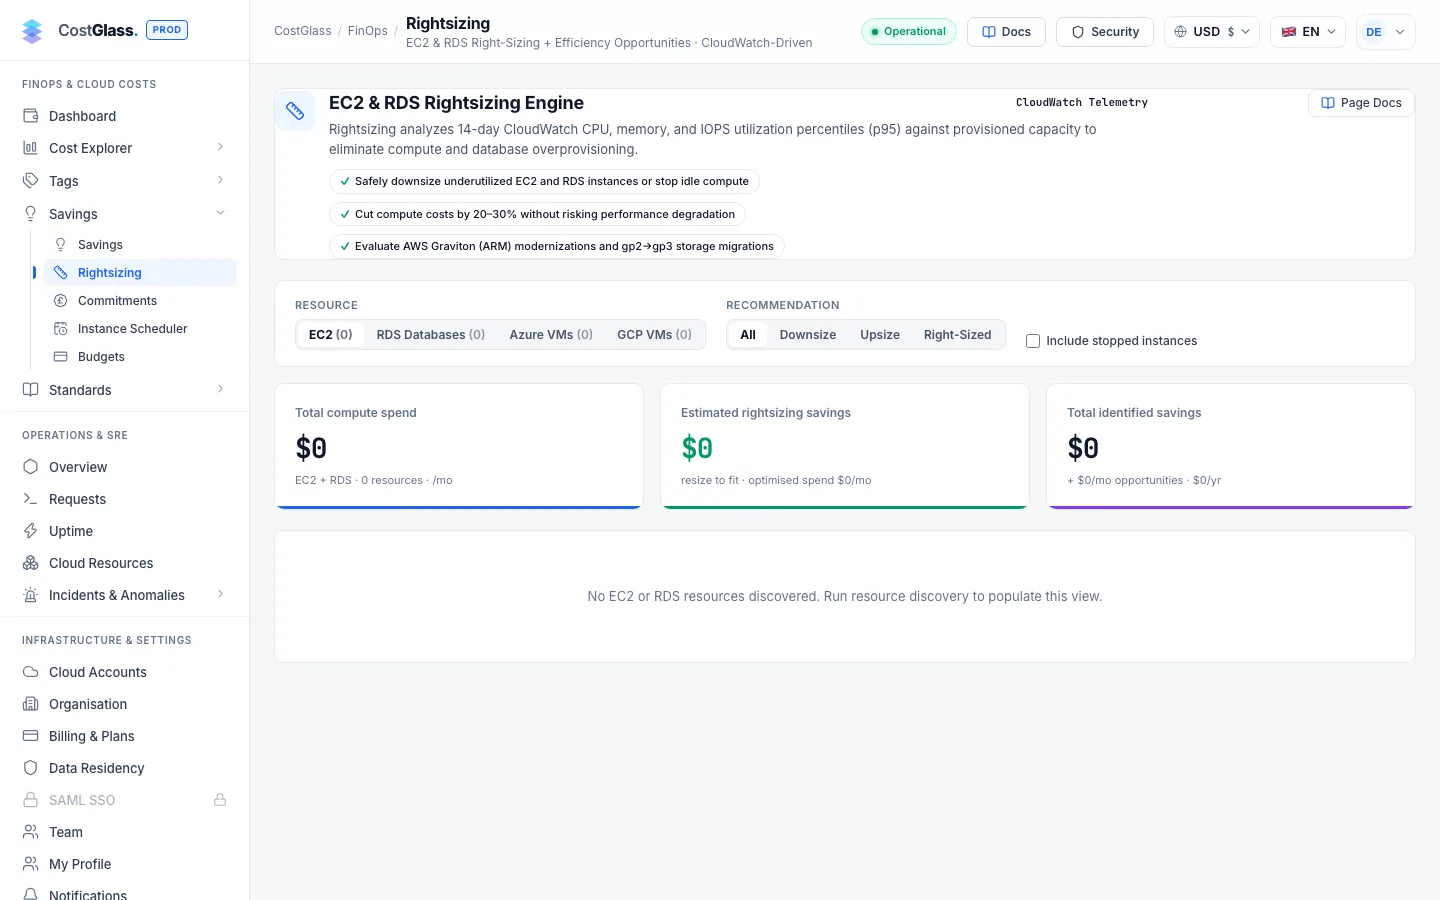
Que signifie le redimensionnement
Quand quelqu'un crée un serveur, il choisit souvent une taille généreuse "par sécurité", et il n'est jamais revisité. Vous payez la taille entière toutes les heures, même si vous n'en utilisez qu'une fraction. Rightsizing recherche ces serveurs et suggère la taille inférieure suivante dans la même famille, ce qui réduit le prix de ce serveur. Il signale également les serveurs trop chauds, pour lesquels une taille plus grande protégerait vos clients.
- Processeur p95
- Le 95e centile d'utilisation du processeur : le niveau qui n'a été dépassé que 5 % du temps. Il décrit les périodes de pointe, ignorant les pics les plus rares. It is a better guide to "how big does this need to be" than the average.
- Mémoire p95
- La même mesure pour la mémoire.
- Famille et taille
- Un type de serveur tel que m6i.large a une famille (m6i) et une taille (large). CostGlass recommande la taille voisine dans la même famille, une étape à la fois, car c'est le changement le plus sûr.
- Confiance
- Quelle quantité de preuves se cachent derrière une recommandation : élevée, moyenne ou faible (expliquée ci-dessous).
D'où viennent les mesures
| Nuage | Source | Ce que vous devez faire |
|---|---|---|
| AWS EC2 et RDS | Amazon CloudWatch (GetMetricData, last 14 days, hourly). Memory comes from the CloudWatch agent (CWAgent) if it is installed. AWS Compute Optimizer est également lu, sous la forme d'un deuxième avis affiché sur chaque ligne. | Activez Rightsizing dans votre pile ; installez l'agent CloudWatch pour la mémoire ; vous pouvez éventuellement vous inscrire à Compute Optimizer. |
| Machines virtuelles Azure | Azure Monitor (CPU, plus mémoire disponible là où la VM le signale). | Rien de plus. L’accès lecteur est suffisant. |
| Google Cloud | Cloud Monitoring n'est pas lu aujourd'hui, donc les VM affichent Nécessite un accès aux métriques. | Rien de disponible pour l'instant. |
| Kubernetes | OpenCost : efficacité des requêtes de conteneur de chaque charge de travail. | Connectez OpenCost. Voir les coûts de Kubernetes. |
| Modèles d'IA | Vos dépenses réelles OpenAI ou Anthropic par modèle. | Connectez la plateforme IA. |
Configurez-le (AWS)
- Un compte AWS connecté avec un accès en direct (pas seulement une exportation de facturation).
- Quelqu'un qui peut déployer ou mettre à jour une pile CloudFormation dans ce compte.
- Serveurs qui fonctionnent depuis au moins une semaine.
mem_used_percent. Sans cela, des recommandations concernant uniquement le processeur sont toujours formulées, mais avec un niveau de confiance moindre et avec un rappel de vérifier d'abord la mémoire.Les règles que CostGlass applique
Les seuils sont fixes et s'appliquent à chaque client.
| Recommandation | Quand il est fait | Preuves nécessaires |
|---|---|---|
| Réduire les effectifs | Le processeur p95 est inférieur à 40 % et la mémoire p95 est inférieure à 40 % lorsque la mémoire est mesurée, et le serveur de taille unique restera toujours égal ou inférieur à 80 % p95 après le changement. L'économie doit également être supérieure à 5 % du prix actuel. | 7 jours |
| Augmenter la taille | CPU p95 égal ou supérieur à 85 %, ou mémoire p95 égale ou supérieure à 90 %. Montré comme un coût supplémentaire (une économie négative) et non inclus dans les totaux des économies. | 7 jours |
| Inactif | EC2 : CPU moyen inférieur à 3%, p95 inférieur à 10% et réseau inférieur à 100 Mo par jour. RDS : aucune connexion à la base de données. | 12,5 jours |
| De bonne taille | Rien de ce qui précède ne s'applique. Laissez-le tranquille. | 7 jours |
| Aucune donnée d'utilisation | Pas assez d'historique, pas en cours d'exécution, aucune région enregistrée ou CloudWatch n'a rien renvoyé. La ligne indique la raison. | - |
| Nécessite un accès aux métriques | CostGlass ne peut pas lire les métriques de ce cloud (actuellement les VM Google Cloud). | - |
Confiance
| Niveau | Quand |
|---|---|
| Élevé | Au moins 12,5 jours de données et de mémoire ont été mesurés. |
| Moyen | Au moins 12,5 jours de données mais la mémoire n'a pas été mesurée. Ou une confiance élevée abaissée parce que les courtes rafales atteignent la limite de taille actuelle. |
| Faible | Entre 7 et 12,5 jours de données, ou support baissé à cause des salves. |
Si les rafales (le pic, pas p95) dépassaient la capacité du plus petit serveur, l'explication le dit : "les rafales courtes atteignent la limite de taille actuelle, alors vérifiez la charge maximale avant de redimensionner".
Comment lire la page
Cartes d'en-tête
- Dépenses totales pour la flotte et l'IA
- Coût mensuel estimé des ressources analysées, au prix catalogue.
- Économies de redimensionnement (mesurées)
- La somme des économies réalisées grâce aux recommandations basées sur une utilisation mesurée. Les estimations des ressources sans mesures ne sont pas incluses. Before data exists this card reads "No utilisation data yet".
- Économies totales identifiées
- Redimensionner les économies ainsi que les opportunités d'efficacité supplémentaires répertoriées plus bas sur la page.
Onglets et filtres de la plateforme
Choose a platform with All Platforms, Kubernetes, AWS, Azure, Google Cloud or AI Models (the number in brackets is how many items it holds). Sous Recommandation, choisissez Tout, Réduire la taille, Inactif, Augmenter la taille, Dimensionner correctement ou Aucune donnée. Cochez Inclure arrêté pour inclure les serveurs qui ne sont pas en cours d'exécution.
| Contrôle | Options |
|---|---|
| Recherchez par nom, identifiant, fournisseur ou taille… | Texte libre. |
| Toutes les régions/clusters | Limité à une région ou à un cluster Kubernetes. |
| Toute confiance | Élevé, moyen ou faible. |
| Trier | Biggest saving first (default), Highest cost first, Name A–Z. |
Le tableau
| Colonne | Ce qu'il vous dit |
|---|---|
| Ressource/charge de travail | Nom, badge cloud, région et état. |
| Spécification actuelle | Type d'instance avec vCPU et mémoire. |
| £/mois actuel | Prix catalogue mensuel estimé maintenant (affiché dans la devise de votre choix). |
| Processeur p95 | Barre affichant les périodes d'occupation du processeur. Un tiret signifie non mesuré. |
| Mémoire p95 | Idem pour la mémoire. Un tiret signifie que la mémoire n'est pas mesurée (voir l'agent CloudWatch). |
| Taille/niveau recommandé | La pilule du verdict et, en cas de réduction ou d'augmentation de la taille, le type de cible. |
| Nouveau £/mois | Prix catalogue de la taille recommandée. |
| Économiser £/mois | La différence. Un montant négatif (orange) correspond à un coût supérieur. |
Cliquez sur une ligne pour la développer : moyenne du processeur et p95, mémoire p95, réseau ou connexions de pointe, la source de données, les résultats d'AWS Compute Optimizer (si vous avez choisi), la confiance, la nouvelle capacité et une justification en anglais simple.
Opportunités supplémentaires
Sous le tableau, les opportunités d'optimisation multiplateforme répertorient les gains d'efficacité trouvés dans votre inventaire : disques non connectés, types d'instances de génération précédente, déplacements Graviton ou ARM, mise en cache rapide et API par lots pour l'IA. Il ne s’agit pas d’une utilisation mesurée et sont séparés du total des économies mesurées.
Comment exécuter une recommandation en toute sécurité
Des limites honnêtes
- Aucune métrique, aucune recommandation. CostGlass ne modélise ni ne devine l'utilisation. Un serveur qu'il ne peut pas mesurer est affiché avec la raison.
- Les prix sont approximatifs. Il s’agit de prix catalogue à la demande issus des tableaux intégrés de CostGlass. Les tarifs, crédits et réductions réservés ou Savings Plan ne sont pas appliqués, les économies réelles peuvent donc différer. La mémoire Azure et les prix sont également des approximations.
- Seule la taille voisine dans le même famille . Le passage à une autre famille (par exemple vers Graviton) apparaît comme une opportunité supplémentaire et non comme une recommandation mesurée.
- Les métriques couvrent les 14 derniers jours. Une quinzaine tranquille peut cacher une fin de mois chargée.
- Google Cloud VMs show Needs metrics access: CostGlass does not yet read Cloud Monitoring.
- Les suggestions de modèles d'IA sur cette page utilisent des hypothèses fixes sur les niveaux de modèle et ne font pas partie du total mesuré.
- Les résultats du dimensionnement dépendent de la découverte des ressources. Un serveur qui n'a pas été découvert n'apparaîtra pas.